Engineering-Fallstudie · Dokumentmodelle · Open Source
Wie das Einfügen einer Zeile in Docling Core gültige Tabellendaten verfälscht
Minimalbeispiel · Regressionstests · Upstream-PR #943
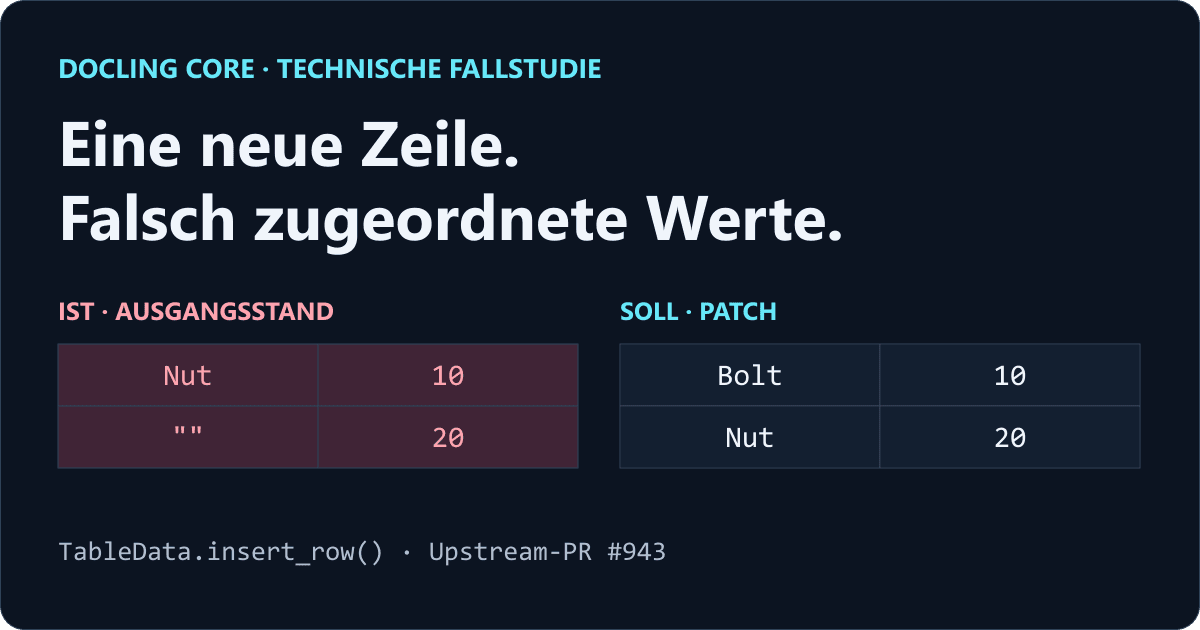
In dieser Fallstudie
Aus Nut | 20 wurde Nut | 10, obwohl der Aufruf nur eine weitere Zeile einfügen sollte. Die Methode kehrte ohne Fehler zurück. Auch die 20 war noch da, eine Zeile tiefer neben einer leeren Bezeichnung. Wer nur die Zeilen zählt oder prüft, ob alle ursprünglichen Zeichenketten noch vorkommen, übersieht den Fehler. Entscheidend ist, ob Bezeichnung und Wert weiterhin zusammengehören.
Drei Zeilen genügen
Die Zelle Stock überspannt beide Spalten. Darunter stehen zwei gewöhnliche Datenzeilen. Der Aufruf data.insert_row(1, ["Washer", "30"]) fügt die neue Zeile vor der Zeile mit Index 1 ein, gezählt ab null. Hier ist jeweils der Text aus data.grid zu sehen. Im Original und im erwarteten Raster erscheint Stock zweimal, weil dieselbe Zelle beide Positionen abdeckt. "" steht für eine unbelegte Position mit leerem Text.
Originalraster     Ist auf getestetem Upstream   Soll / vorgeschlagener Patch
Stock  | Stock     Bolt   | Stock                Stock  | Stock
Bolt   | 10        Washer | 30                   Washer | 30
Nut    | 20        Nut    | 10                   Bolt   | 10
                   ""     | 20                   Nut    | 20
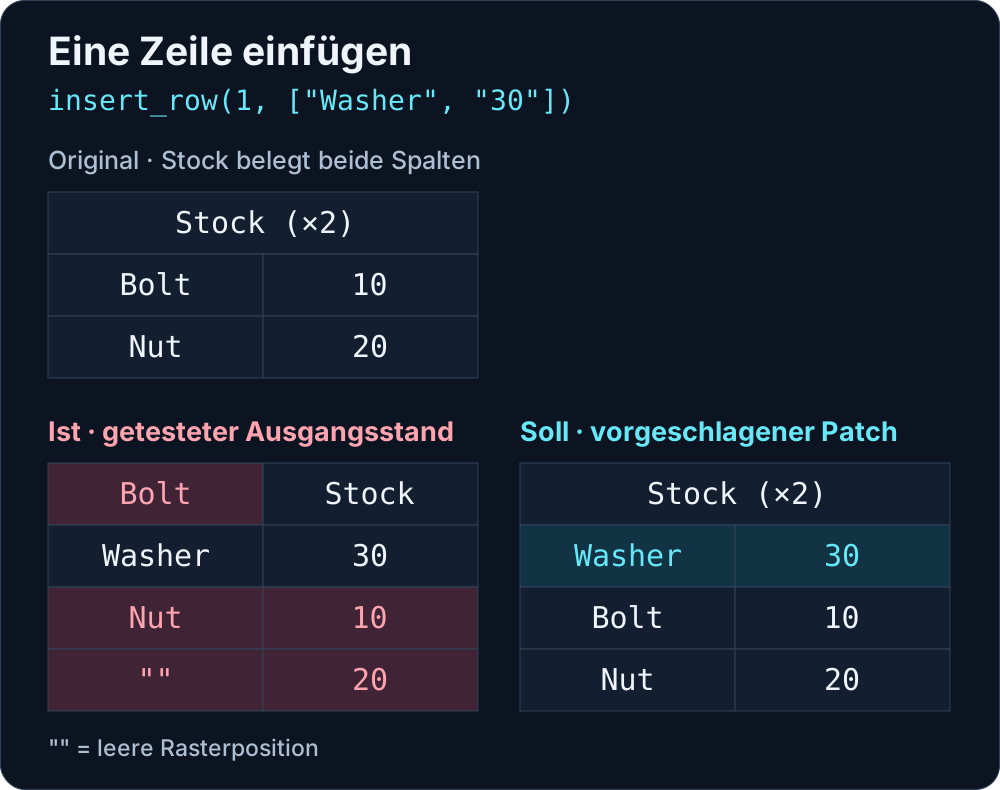
Das Beispiel erzeugt TableData direkt mit Docling Core 2.105.0 auf Commit 2dc4c9f511269eb39be5aad84b838f7bb179142e. Dafür braucht es weder ein PDF noch ein Modell. Im Dokumentmodell betrifft der Fehler insert_row, insert_rows und über denselben Einfügepfad auch add_row. Issue #942 mit ausführbarem Beispiel
Zellliste und Raster sind zwei Darstellungen
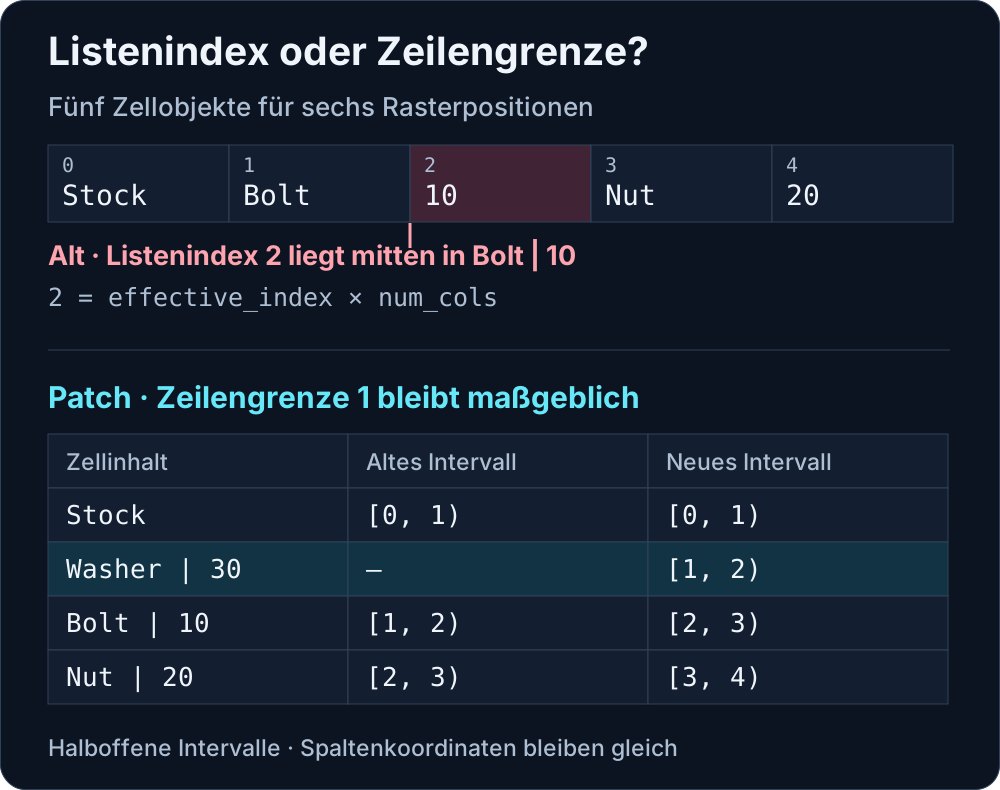
table_cells enthält pro gespeicherter Zelle ein Objekt. Zeilen- und Spaltenkoordinaten beschreiben jeweils ein halboffenes Intervall. Eine verbundene Zelle kann mehrere Spalten oder Zeilen abdecken. In einem lückenhaften Raster können Positionen unbelegt bleiben. Die Zellobjekte müssen in der Liste auch nicht zeilenweise sortiert sein. grid belegt seine Positionen anhand der Koordinaten. Im Beispiel reichen fünf Zellobjekte für sechs Rasterpositionen. Rasterimplementierung auf dem getesteten Stand
Der bisherige Code fügte die neuen Objekte an Listenposition effective_index * self.num_cols ein. Die ursprüngliche Schleife berechnete anschließend für jede Zelle das Zeilenintervall aus der Listenposition neu.
for index, cell in enumerate(self.table_cells):
    new_index = index // self.num_cols
    cell.start_row_offset_idx = new_index
    cell.end_row_offset_idx = new_index + 1
Mit zwei Spalten und Einfügegrenze 1 landet die neue Zeile ab Listenindex 2. Bolt, die erste Zelle von Zeile 1, steht aber schon an Listenindex 1, weil der Tabellenkopf nur ein Objekt belegt. Die Schleife weist Bolt deshalb Zeile 0 zu. Beim Aufbau des Rasters überschreibt es die linke Position von Stock. Nut und 10 landen gemeinsam in Zeile 2. Da die Spaltenkoordinaten gleich bleiben, sieht die falsche Zuordnung wie ein plausibler Datensatz aus. Dieselbe Schleife setzt jedes Zeilenintervall auf die Länge eins, auch bei einer vertikal verbundenen Zelle. Ursprünglicher Einfüge- und Nummerierungscode
Koordinaten verschieben, Zellen erhalten
Der Patch berechnet die Einfügegrenze unter Berücksichtigung von after=True. Er prüft die Breite jeder neuen Zeile, die Gültigkeit der Grenze und ob sie durch eine vertikal verbundene Zelle verläuft. Erst wenn alle neuen TableCell-Objekte erfolgreich erzeugt sind, ändert er eine bestehende Zelle. Die neuen Zellen belegen aufeinanderfolgende Zeilen in der vorgegebenen Reihenfolge. Bei den bestehenden Zellen verschiebt die folgende Schleife beide Zeilenkoordinaten gemeinsam.
for cell in self.table_cells:
    if cell.start_row_offset_idx >= effective_index:
        cell.start_row_offset_idx += len(rows)
        cell.end_row_offset_idx += len(rows)
Beide Intervallgrenzen rücken gleich weit, die Ausdehnung bleibt erhalten. Zellen vollständig oberhalb der Einfügegrenze behalten ihre Koordinaten. Der Code verwendet die vorhandenen Objekte weiter. Text, Markierungen, Begrenzungsrahmen, Spannen, Spaltenkoordinaten und Verweise von RichTableCell bleiben erhalten. Auch die referenzierte Dokumentgruppe mit ihrem Inhalt und die vorhandenen Herkunftsdaten der Tabelle bleiben bestehen. Neue Werte bekommen Tabellenkoordinaten, aber keine erfundene Position im Quelldokument. Implementierung im eingereichten Commit
Liegt die Einfügegrenze innerhalb eines Zeilenintervalls, meldet der Code einen ValueError. Bei einer Zelle mit [0, 2) würde die Grenze 1 eine vollständige neue Zeile in einen Bereich legen, den diese Zelle bereits belegt. Eine Vergrößerung der verbundenen Zelle könnte neue Werte verdecken. Beim Teilen wäre zu entscheiden, welchem Teil der vorhandene Inhalt gehört. Anfang und Ende der Spanne sind zulässige Grenzen, sofern dort keine andere Zelle überschnitten wird. Falsche Zeilenbreiten, ungültige Zellwerte oder Einfügepositionen und solche Überschneidungen lassen die Tabelle bei insert_rows unverändert. insert_row ruft diese Methode auf, und add_row nutzt sie über insert_row. add_rows hängt weiterhin einzeln an und hat diese Garantie für den ganzen Stapel nicht.
Auch das Ersetzen der Zellliste bleibt erhalten. Die neuen Einträge kommen vor den ersten Listeneintrag, dessen Startkoordinate an oder unter der Einfügegrenze liegt. Die alten Einträge behalten ihre relative Reihenfolge. Wo die neuen Objekte in der Liste stehen, ist eine Frage der Speicherung. Auch bei einer unsortierten Liste ergibt sich das Raster aus den Koordinaten. Wer die alte Liste noch referenziert, sieht darin keine neuen Einträge. Die gemeinsamen Zellobjekte können jedoch aktualisierte Zeilenkoordinaten haben. Eine frühere lokale Fassung hatte die Liste direkt verändert. Im Abschlussaudit fiel der Unterschied auf und erhielt einen eigenen Regressionstest.
Bei den getesteten rechteckigen Tabellen bleibt das Verhalten gleich. Bereits beschädigte Tabellen und beliebige fehlerhafte Zellkoordinaten werden durch den Patch nicht repariert. Die kleine Korrektur im Test zur Platzierung von Tabellenbeschriftungen folgt aus dem Verhalten beim Anhängen. Die Testtabelle beginnt jetzt mit null Zeilen und hängt einmal an. Zuvor deklarierte der Test erst eine leere Zeile, hängte eine weitere an und setzte dann den Zeilenzähler zurück. Commit mit den drei geänderten Dateien
Was die Regressionstests belegen
- 27 von 27 gezielten Einfügetests bestanden jeweils unter Python 3.10.22, 3.12.14 und 3.14.10. Dieselbe Testdatei ergab auf unverändertem Upstream unter Python 3.12.14 19 Fehlschläge und acht bestandene Fälle. Die acht Fälle prüfen weiterhin gültiges Verhalten. Im Audit wurde der Importpfad von
TableDatakontrolliert, damit nicht versehentlich beide Läufe die korrigierte Implementierung testen. Eingereichte Regressionstests - 400 generierte rechteckige Tabellen lieferten identische Modelldaten auf dem Ausgangsstand, mit jedem Patch einzeln und mit beiden Patches zusammen. Abgedeckt waren alle vier Ausrichtungen, Nulldimensionen, Zellmarkierungen und Begrenzungsrahmen. Der Vergleich lief lokal. Die generierten Testfälle und das Skript sind unveröffentlicht. Eine unabhängige Überprüfung steht aus.
- Im lokalen Windows-Lauf schlugen vor und nach dem Patch dieselben 47 Tests fehl. Auf dem Ausgangsstand bestanden 1.081 Tests, mit Einfügepatch 1.108. Jeweils neun Fälle wurden übersprungen, ein weiterer schlug erwartungsgemäß fehl. Die Kennungen der fehlschlagenden Fälle stimmten überein. Laut Aufzeichnung erreichte keiner dieser Fälle eine Einfüge- oder Anhängemethode. In der Testumgebung fehlte der Build der Java-Grammatik. Ein zuvor abgestürztes optionales Saxon-Backend war ebenfalls ausgeschlossen. Die vollständige Linux-CI und der Einsatz mit Produktionsdaten bleiben ungeprüft. Testbefehle und Angaben zur Umgebung in PR #943
Das Beispiel im Issue lässt sich unabhängig von der Testsuite ausführen. Für den gezielten Vergleich zuerst den PR-Head abrufen, die Commit-ID prüfen und je einen sauberen Checkout für den eingereichten Commit und seinen Elterncommit anlegen. Die folgenden Befehle in jedem Checkout ausführen. Die Testdatei kommt in beiden Fällen aus dem Checkout des eingereichten Commits. Die Umgebung stammt jeweils aus dem Checkout unter Test.
uv sync --frozen --all-extras --all-packages
uv run --no-sync python -c 'import inspect; from docling_core.types.doc import TableData; print(inspect.getfile(TableData))'
uv run --no-sync pytest -q --import-mode=importlib /absolute/path/to/submitted/tests/test_table_row_insertion.py
Der ausgegebene Modulpfad muss zum Checkout unter Test gehören. Der eingereichte Commit und der letzte lokale Audit-Commit haben denselben Git-Tree. Eingereichter Commit und festgehaltener Ausgangsstand
Wie der Löschpatch dazu passt
PR #927 korrigiert dieselbe Annahme über die Zellliste in remove_rows. Beim Löschen entscheidet der Code anhand der Koordinaten, welche Zellen entfallen, schrumpfen oder verschoben werden. Mit dem Einfügepatch allein schlägt der Löschtest weiterhin fehl. Mit dem Löschpatch allein schlagen dieselben 19 Einfügetests fehl. Die Patches betreffen zwei getrennte Operationen.
Für das lokale Audit wurde der Einfügepatch mit #927 auf Commit e8a761c98976feadafa8137db3196ff6d37df3c6 kombiniert. Jeder der 200 synthetischen Fälle mit festem Zufallsseed fügt an einer Zeilengrenze eine bis drei Zeilen in eine Tabelle mit gemischter Zellreihenfolge und horizontal verbundenen Zellen ein. Danach werden genau die neuen Zeilen gelöscht und sämtliche serialisierten Modelldaten mit dem Ausgangszustand verglichen. In Kombination stellten die Patches 200 von 200 Tabellen wieder her. Der Ausgangsstand und die beiden Einzelpatches kamen jeweils auf 18 von 200. Eine zusätzliche Testtabelle mit RichTableCell lieferte nur in der Kombination wieder das vollständige Ausgangsdokument samt Gruppenverweis und Herkunftsdaten. PR #943 nennt das Ergebnis der 200 Fälle. Die generierten Testfälle und das Skript sind unveröffentlicht. Die lokalen Ergebnisse wurden nicht unabhängig überprüft. Echte Dokumente kamen im Audit nicht zum Einsatz. Ergebnisangabe in PR #943 · Getesteter Commit des Löschpatches
Eine beobachtete Einschränkung beim Löschen bleibt auch in der Kombination bestehen. Wird eine Zeile aus einer bestehenden zweizeiligen Zelle gelöscht, kann ihr Koordinatenintervall auf [0, 1) schrumpfen, während row_span=2 stehen bleibt. Der Versuch ergibt mit #927 allein dasselbe. Der Einfügepatch ändert diesen Löschpfad nicht. Die 200 Fälle löschen jeweils neu eingefügte Zeilen und prüfen keine Löschung durch eine ursprüngliche vertikale Spanne.
Was die Upstream-Prüfungen abdecken
Vor der Einreichung bestand ich auf dem Vergleich mit unverändertem Upstream und einem isolierten Test mit #927. Das öffentliche Issue enthält das kleinste reproduzierbare Beispiel. Der PR umfasst einen Commit mit einem Titel nach Conventional Commits und einem Signed-off-by-Eintrag. Er ändert die Implementierung, ergänzt ein Modul für Regressionstests und korrigiert die Testvorlage für die Tabellenbeschriftung. Mit dem Developer Certificate of Origin bestätigt der Beitragende sein Recht, die Änderung unter der Projektlizenz einzureichen, und nimmt die öffentliche Dokumentation des Beitrags zur Kenntnis. Die automatische DCO-Prüfung kontrolliert den Sign-off. Beitragsrichtlinien · DCO 1.1
Stand vom 3. November 2026. #943 ist offen und steht auf 8c8cd3b8371910769f9f23a81b47dbf1bff3e40b. Lint, Typprüfung, DCO und DCO Advisor sind erfolgreich. Für den vollständigen Workflow meldet GitHub action_required. Ein Maintainer muss den Lauf freigeben. Die Merge-Regel für Teständerungen verlangt zwei Freigaben durch Reviewer. Auf GitHub war kein menschliches Review verzeichnet. Die automatische KI-Triage ordnete die Änderung ein und verwies auf den verwandten PR #927. Ein separates, beratendes KI-Erstreview prüfte den gesamten Diff und meldete keinen blockierenden Befund. Beide lasen den Code, ohne ihn auszuführen. Eine Freigabe durch Maintainer lag damit nicht vor. Auch #927 war auf dem getesteten Commit noch offen. PR und Reviews · Schnellprüfungen · Vollständiger Workflow · Automatische KI-Triage · Beratendes KI-Erstreview
Was ich beim nächsten Mal zuerst testen würde
Ich würde mit einem Wertepaar beginnen, dessen Bestandteile nach der Änderung noch vorhanden sind, und prüfen, ob sie auch weiterhin zusammengehören. Bei koordinatenbasierten Tabellen würde ich das aufgebaute Raster, die gespeicherten Koordinaten und die unveränderten Zellinhalte getrennt prüfen. Lücken, unsortierte Zellen, horizontale und vertikale Verbindungen sowie Änderungen an und innerhalb einer Spannengrenze gehören von Anfang an in die Testfälle.
Dieselben neuen Tests würde ich auch auf dem festgehaltenen Upstream-Stand ausführen. Beobachtbares Verhalten wie die Identität von Liste und Zellobjekten verdient dabei eigene Assertions. Bei einer Fehlermeldung kann der Aufrufer eine gültige Grenze wählen. Kehrt die Methode erfolgreich zurück und ordnet die 10 einem anderen Datensatz zu, fehlt jeder Anlass zur Nachprüfung. Ein automatisches Review kann einen verdächtigen Diff markieren. Das Minimalbeispiel, der Vergleich mit Upstream und die noch ausstehenden Maintainer-Prüfungen beantworten jeweils andere Fragen.
Wenn gültiges JSON nicht genügt untersucht dasselbe Grundproblem bei KI-Tool-Aufrufen. Auch eine strukturell gültige Antwort kann die falsche Aktion beschreiben.